robots.txt 封鎖 JS:香港網站點判斷
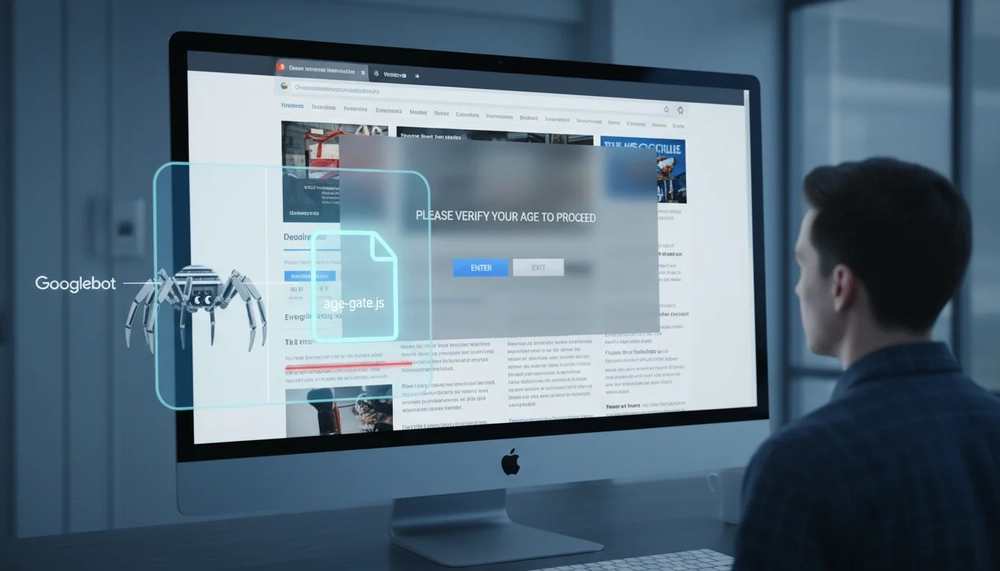
2026 年 11 月,Google 的 John Mueller 在 Reddit 回答一條假設問題,確認網站可以用 robots.txt 阻止 Googlebot 下載年齡驗證彈窗所用的外部資源,彈窗照樣對人顯示,爬蟲就不會渲染它。對香港做網站的團隊來說,這件事的價值不在「可以做」,而在判斷欄位:封的是哪一個檔案、封了之後頁面還能不能正常載入、爬蟲與 AI 系統各拿到幾多內容。要處理geo 服務 收費 香港這類預算問題之前,先要分清楚哪些封鎖屬技術優化、哪些是自斷生路。
重點摘要
- Mueller 指出兩條路:由外部域名的 robots.txt 封鎖整段嵌入內容,或在自己的 robots.txt 封鎖載入彈窗的那個 JS 檔案。
- 若同一支 JS 檔同時負責其他功能,他明言不建議直接封鎖。
- 前提是頁面在缺少被封資源時仍能正常載入,這一點由網站自己驗證,Google 不會代你檢查。
- 封鎖只影響爬蟲渲染,不影響人看到的頁面,兩者要分開記錄。
- AI 搜尋系統讀取的也是同一批頁面與資源,封鎖前要看一次 AI 端能否取得完整內容。
目錄
- 這件事對生意的實際影響
- Mueller 講了兩條路,分別封甚麼
- 封錯的代價:依賴鏈與渲染斷點
- 五步核對封鎖前後的分別
- 封鎖與 AI 曝光:影響品牌在ai的曝光的技術層
- Topkee 的看法:robots.txt 與網站地圖要一對一核對
- 下一步做咩
- 常見問題
- Sources
這件事對生意的實際影響
彈窗這類東西通常被當成「用戶見到、爬蟲不需要見」的元素,處理得隨意。但 robots.txt 的封鎖範圍由檔案路徑決定,不由你的意圖決定。同一個目錄下的推廣腳本、頁面主要內容的渲染邏輯,只要寫在同一支檔案裡,一封就一齊消失。之前不少網站為了省爬取預算而封鎖 CSS 與 JS,結果排名掉下來,原因就是渲染時缺料。
換到漏斗的角度看:封鎖你以為無關的資源,可能令產品頁在爬蟲眼中只剩骨架,收錄的頁面描述失準,之後由搜尋與 AI 答案帶來的查詢就少了入口。這一步不會即時見到,要等下次重新抓取與索引才浮現,所以更值得事前核對。
Mueller 講了兩條路,分別封甚麼
第一條路針對外部域名。問題裡的彈窗由 verificationpopup.com 經 API 插入頁面,若該外部域名的 robots.txt 全面封鎖爬取,Googlebot 渲染時不會抓這段內容,也就無法用它組出彈窗。Mueller 說廣告服務普遍就是這樣運作:爬蟲不會把那些 URL 當成獨立頁面爬,但渲染時會試著抓,被 robots.txt 擋住就取不到。
第二條路針對自家網站。若網站用一支專用 JS 檔(他的例子是 load-verification-popup.js)去載入彈窗,可以直接在自己的 robots.txt 封鎖這個檔案,渲染時腳本不會執行。他指出這種做法較少見,但當外部域名的 robots.txt 不在你控制範圍內,這就是唯一能做的選擇。
兩條路的分別在控制權:外部域名的指令你能建議、未必能改;自家網站的指令你隨時可改、也隨時可能改錯。所以動手之前要問清楚兩點. 第一, 呢個 robots.txt 邊個有權改. 第二, 一旦封鎖, 邊個頁面會缺件.
香港網站最常誤封的三類檔案
在香港見到的個案,原因通常是路徑寫得太闊,並非存心封鎖重要內容。第一類是把整個 js 目錄一次封掉,理由是省爬取預算,結果版面腳本一齊被擋。第二類是舊版 robots.txt 沿用多年,當年用的檔名還留著,後來的建站工具改了路徑卻無人更新指令。第三類是處理歷史內容更新時,把舊網址整段設為封鎖,連同仍在使用的資源一併排除。
封錯的代價:依賴鏈與渲染斷點
Mueller 對「只有一支 JS 檔做很多事」的情況直接叫停。實務上這種檔案很常見:建站框架把追蹤、版面組件、表單驗證與彈窗邏輯打包在一起,檔名看不出內容。封鎖它,等於同時拆掉幾樣東西。
判斷方法不需要猜檔名,看依賴就可以:
| 資源類型 | 封鎖後的風險 | 處理方向 |
|---|---|---|
| 專責彈窗的獨立腳本 | 低,彈窗不再被渲染 | 可考慮封鎖 |
| 同時處理版面或表單的打包腳本 | 高,頁面在爬蟲眼中缺件 | 先拆檔,再封目標那支 |
| 外部域名的嵌入內容 | 視對方 robots.txt,你未必能改 | 先確認對方設定 |
| CSS 或主要內容渲染所需資源 | 極高,過往曾令排名下滑 | 不封 |
另一點是載入條件。Mueller 提醒網站要確保頁面在這些 URL 不被抓取時仍正常載入。彈窗類服務通常有降級處理,但如果你的程式碼假設腳本一定成功載入才顯示內容,封鎖就會把整個頁面卡住。這一項要用無痕視窗加封鎖條件實測,不能只看開發環境。
五步核對:robots.txt 封鎖 JavaScript 前如何確認不影響渲染與收錄
第一步,列出所有會被影響的頁面。從網站地圖與內部連結拿到清單,標明哪些頁面會出現這個彈窗。
第二步,找出真正負責的檔案。在瀏覽器開發者工具看網絡請求,確認是獨立腳本還是打包檔,記錄完整路徑。
第三步,寫下預期結果:封鎖後人看到甚麼、爬蟲應該拿到甚麼。這段文字是之後核對的依據。
第四步,在測試環境加上 robots.txt 規則,用 Google 的網址檢查工具要求抓取並看渲染結果,對照第三步的預期。若主要內容消失,立即回退。
第五步,上線後逐週看報表:索引狀態、頁面呈現的標題與描述、來自有機搜尋的查詢有沒有異常。出現問題時,第一步的清單就是回退範圍。
另一個常見誤解是把效能優化與爬取控制混為一談。刪除不必要的 JavaScript、限制請求數量是為了縮短載入時間、降低跳出率,處理的是讀者在瀏覽器的體驗;某個檔案是否被爬蟲下載,處理的是另一個層面。前者做得好,不代表可以順手在 robots.txt 把同一批檔案封掉,兩件事要分開記錄、分開驗證。
封鎖與 AI 曝光:影響品牌在ai的曝光的技術層
AI 搜尋的答案來自對網頁的檢索與理解,讀取的對象跟 Googlebot 渲染面對的是同一批頁面與資源。robots.txt 封得過闊,傳統搜尋與 AI 系統會一齊少掉內容。
值得分開看的是三個數字:被檢索的來源、答案裡真正顯示的引用、以及引薦到網站的流量。前兩者是 AI 答案的屬性,第三個要看網站日誌。把檢索來源當成引用率,會高估成效;把其中一項當成封鎖的藉口,又會低估風險。所以建議每次改 robots.txt 前後,都同步記錄 AI 答案有沒有提到品牌、引用了哪個頁面,兩組資料一齊看,才知道封鎖是解決了問題還是製造了問題。這也是評估生成式引擎優化之前應有的基線。
Topkee 的看法:robots.txt 與網站地圖要一對一核對
Topkee 的 Weber SEO 工具會為網站自動產生 robots.txt 檔,站方可在檔內撰寫指令,告訴網絡機器人如何爬行與索引,用來處理歷史內容更新造成的問題,確保讀者與搜尋引擎被正確引導至目標頁面。Weber 的 SEO 基礎設施同時以動態 XML 網站地圖自動建立並維護全部頁面與頁面關係,供搜尋引擎找尋和爬取允許的頁面;技術 SEO 則透過網站架構優化,擴展 Google 爬蟲索引範圍、提升頁面收錄效率。兩者合起來,就是「排除」與「允許清單」的分工:robots.txt 只寫要排除的路徑,網站地圖列出要收錄的頁面,兩份清單要能一對一核對。
Topkee 的 SEO 審計以多項指標診斷,檢查清單明列「Robots.txt 可用性及設定是否正確,防止封鎖重要頁面」,同時涵蓋網站地圖、錯誤連結、HTTPS、重定向、網站結構與載入速度,並有定期自動化複檢。這個次序對應新聞的風險面:封鎖前先確認哪些頁面與資源屬重要內容,封鎖後靠複檢查出副作用。
GEO 方面,Topkee GEO 從真實買家問題出發,流程包含提示詞追蹤、查詢扇出分析、情感與品牌描述、競爭對手對比、AI 瀏覽分析及知識內容撰寫。AI 瀏覽分析會檢視檢索來源、引用頁面與網站基本可讀性,並區分「被檢索來源」與「答案中的可見引用」。這項分析不等於實際網站訪問,引薦流量要另接網站數據。改動 robots.txt 之後,這套觀測可以告訴你 AI 端還是否讀得到頁面,而不是只看 Google 搜尋的收錄數字。
封鎖決定的核對表
把下面的欄位填完再動手,任何一格答不出來就先不封。
- 資源路徑:完整檔案路徑,不含目錄代替符。
- 依賴範圍:這支檔案還負責哪些版面、表單或追蹤功能。
- 降級行為:腳本失敗時頁面是否仍顯示主要內容。
- 影響頁面:按網站地圖列出的頁面清單與數量。
- 回退方式:把指令刪掉之後,下一次抓取能否恢復。
- AI 端記錄:改動前一週的答案與引用頁面是否有對照。
- 負責人與複檢日期:誰改、幾時再看一次報表。
下一步做咩
先挑一個頁面做試點,不要一次改整個網站。按上面的五步走完一輪,記錄抓取與渲染的結果,再比對 AI 答案有無提到品牌與引用的頁面。想做完整核對,可以先看 Topkee 的 geo 服務 收費 香港,再配合 Weber 平台的更新記錄了解工具目前的版本,並從 Topkee Media 主站看整體的廣告與搜尋服務範圍。要控制內容供給的節奏,也可以先了解品牌在ai的曝光如何隨每次抓取變動,再定生成式引擎優化的範圍。
常見問題
robots.txt 可以封鎖任何想封的檔案嗎?
技術上可以寫任何路徑,但判斷要看後果。Mueller 建議只封專責某個功能的檔案,若同一支 JS 做很多事就不要封。主要內容渲染所需的 CSS 與腳本,封鎖會令頁面在爬蟲眼中缺件。
封鎖後對人看到的頁面有影響嗎?
robots.txt 是給爬蟲看的指令,人瀏覽時照樣會載入被列出的資源。因此彈窗這類只對人顯示的元素是最適合的對象,前提是頁面在爬蟲取不到資源時仍能正常渲染。
外部域名的指令我改不到,還有辦法嗎?
可以改自家網站那一端:若用獨立 JS 檔載入該內容,就在自己的 robots.txt 封鎖這個檔案。這是 Mueller 提出的第二條路,適合外部域名不受你控制的情況。
怎樣確認封鎖沒有弄壞頁面?
在測試環境加上規則後,用網址檢查工具要求抓取並看渲染結果,對照事前寫下的預期。上線後逐週看索引狀態與頁面呈現的標題描述,出現異常即按預先列好的清單回退。
這件事與 AI 搜尋有關係嗎?
有。AI 系統讀取的也是同一批頁面與資源,封得過闊會令內容在兩邊都少掉。改動前後應同步記錄 AI 答案有沒有提到品牌、引用了哪些頁面,並與網站日誌的引薦流量分開看。
Sources
- "Google Says It's Okay To Block Some JavaScript Resources With Robots.txt" — Search Engine Journal — 2026-11-03 — https://www.searchenginejournal.com/google-says-its-okay-to-block-some-javascript-resources-with-robots-txt/595736/
- "GEO公司|GEO服務・GEO優化與AI搜尋實測|HKINT" — HKINT — https://www.hkint.com.hk/geo/
- "Topkee GEO|生成式引擎優化與 AI 品牌可見度" — Topkee Media — https://www.topkee.com.hk/geo

