AI Agent 實戰只得 12%:GDPx 拆解與落地
截至 2026 年 11 月,如果你正在評估 ai agent development,最值得先看清楚的一個數字是 12%。SemiAnalysis 於 2026-11-02 發布 GDPx 基準測試,把 AI Agent 放進模擬工作環境,用真實專業軟件做任務,結果沒有任何模型總分高過 12%。The Decoder 在 2026-11-06 的報道把結果撮要成一句:分數低,而且有評論者質疑測試的公平性。本文不打算講「Agent 唔得」,而是把這個 12% 拆開:分子分母各是什麼、失分集中在哪幾類任務、企業又要如何設定自己的驗收標準。
重點摘要
- 12% 是整體分數,既非完成率,也不代表各領域表現均勻。
- 任務預設限時 8 小時,失敗集中在長任務中途斷鏈與跨系統操作,而不是單點知識不足。
- 財務類任務用二值評分時全部模型得 0%,因為一個錯格就足以令整份產出無用。
- 提供方自帶的 Agent 軟件不同,等於比賽用具不同,橫向比較要打折。
- 企業驗收應該看完成率、用時、返工與人工介入,而不是看某個通用分數。這是 ai agent development 項目要事先寫定的驗收條件。
GDPx 到底測什麼
GDPx 的設計前提與 OpenAI 的 GDPval 不同。GDPval 的任務把背景資料直接塞進提示詞,模型一次性交出一份文件;GDPx 則給 Agent 一個模擬環境,裡面有數千個檔案、真實的專業軟件、以及需要自己去找的上下文。報道裡提到的例子包括 Siemens NX、有幾千個檔案的資料室,以及活的企業系統。
這批任務由 14 個專門的數據夥伴提供,覆蓋芯片設計、生物、法律、財務、量化交易、網絡安全等領域。這個「14」值得留意。任務由熟悉該行業的人按其日常工作設計,並非一家公司憑空寫出來,問題才有機會「難得合理」。
對營銷與營運團隊而言,這種測法比問答題更貼近現實。真實工作不會把需要的資料整理好放在你面前,它散落在 CRM、ERP、電郵、報表與舊資料庫裡,而找齊資料本身就是工作的一部分。
12% 這個數字怎麼計出來
這裡要劃清定義,因為同一個「12%」可以有幾種完全不同的定義。
先講計法:這項統計會忽略其餘的往返。第二,各領域等權平均,不是按任務數量加權,所以任務少的領域不會被稀釋。第三,任務預設限時 8 小時,部分任務限時更短,逾時即失敗。
以下是我整理的一份對照,方便你在看任何 benchmark 報告時逐項核對:
| 要問的問題 | GDPx 的答案 | 對判讀的影響 |
|---|---|---|
| 分數的性質 | 達標率 | 不等於任務按比例完成 |
| 一次嘗試還是多次取最好 | 三次中的一次 | 重試可以改善,但成本要另計 |
| 各領域如何加權 | 等權 | 難領域不會被易領域蓋過 |
| 限時幾長 | 預設 8 小時 | 長任務對穩定性要求更高 |
| 評分是二值還是部分分 | 視領域而定 | 二值評分下財務全部得 0% |
分清這幾項之後,12% 的意思就變得具體:在一個為期數小時、需要自己找資料、操作真實軟件的任務裡,即使是目前最強的模型,也只有一成左右的機會一次達標。
失分集中在哪裡
失分不是平均分佈的,這點對決定要不要交工作給 Agent 最有參考價值。
財務任務是最極端的例子:用二值評分時,所有模型得 0%。算式本身不難,難在財務工作的容錯極低:一個錯誤的數字就足以令整份產出不能用。報道把這點講得很白:在這種嚴格標準下,沒有任何模型完成過哪怕一個任務,所以報告改為計「達成了幾多項要求」。
量化交易的情況也值得看:在 111 次評分的運行中,多數運行表現差過被要求打敗的參考策略。這個數字說明「寫得出、但寫得比基準差」是常態,與會不會寫程式關係不大。對企業來說,這等於沒有價值,甚至係負價值。
其他失分來源包括:Agent 在長任務中途放棄、誤解跨系統操作的業務邏輯、以及在自己看不到的環節留下錯誤。這些都不是靠換一個更大的模型就會消失的問題。
為什麼「唔好用」這個結論要小心
反過來說,把 12% 讀成「AI 代理完全無用」同樣是錯的讀法。報道引述的批評值得逐點記錄。
第一,安全分類器會壓低部分模型的總分。把網絡安全、生物與對齊三個領域剔除之後,排名會改變,說明分數有一部分反映的是過濾機制,而不是能力本身。
第二,每個模型都在自己提供方的 Agent 軟件裡跑,工具鏈強弱會直接影響成績。這等於不同選手用不同球拍比賽,橫向比較要打折。
第三,任務有一部分是公開的,其餘封閉,並且不少領域用語言模型按評分表批改,外界無法完整驗證難度與評分質素。單一子領域的題目數量亦不多,分數會有波動。
對正打算引入 ai 代理 的團隊,把這三點放回決策裡,結論應該是:12% 是一個有用的警戒線,不是一個最終判決。它告訴你通用 Agent 在無邊界而且要跨系統的長任務上仍然不可靠;它沒有告訴你,在邊界收窄而且結果可驗收的場景裡做不到事。
Does Boot dev use generative AI:教學片答不到的可靠性問題
這一段直接回答很多人搜「Does Boot dev use generative AI」之後其實想問的問題:市面上談 AI Agent 的教學內容很多,但關於它在真實工作裡到底靠不靠得住,證據卻很少。GDPx 是目前少數把 Agent 放進模擬工作環境、用數小時計的任務量度表現的公開測試,所以它對這個問題的參考價值,比任何一篇文章的個人體驗都高。
我自己的讀法是分兩層。第一層是能力上限:目前最強的模型在一個綜合指標上只有約一成機會,這已經足以在收窄範圍而且有人复核的場景裡省下大量工時。第二層是穩定性:8 小時的預設限時說明這些任務的長度遠超一般人想像,長任務中途斷鏈、上下文丟失、跨系統誤操作,都是能力上限之外的問題。
兩層要分開決策。能力不足,靠選場景解決;穩定性不足,靠架構解決。把兩者混在一起講,只會得出一句對決策無幫助的評語。
Topkee 的看法:分數測不到的部分,靠工程化補
Topkee 的 AI Agent 設計正好是針對這幾類失分點做的工程選擇,但它不是在 GDPx 上得分,兩者測的不是同一件事。Topkee 把框架講成三個銜接點:專業方法寫進崗位規則、Skill 與 Playbook;業務系統的查詢與操作接入同一段對話;成果存回 Library 續用。適用場景寫得很清楚:流程相對清晰、資料可獲得、結果能夠驗收的工作。
針對長任務中途失敗,Topkee 的長效 Agent 架構採用一個營銷活動一個獨立實例,各自有獨立工作區、記憶與履歷,上下文互不污染;單次全漏斗診斷耗時由十多分鐘至個半鐘,遇卡頓不重啟,從斷點續跑,成功與超時都留痕,必要時人工可接管終端。
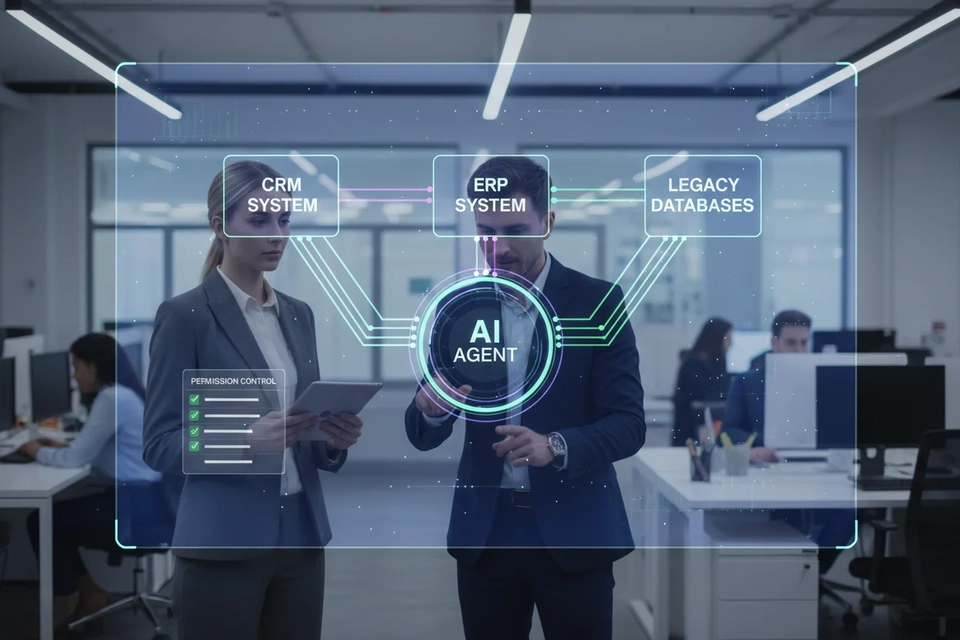
針對跨系統斷鏈,Topkee 稱現有 CRM、ERP、電商商城或舊資料庫可在數天內接入,而不是數月,整合目錄按 7 個類別組織可接入的第三方資料源。這裡要講清楚:這是 Topkee 對自身工程流程的描述,不是對任何客戶的無條件保證,實際範圍要按場景驗收。
針對「不敢放權」,運行記錄與任務清單、證據相關聯,新增支出或發佈需要批准。頁面自己也註明,記錄不是實際完成的獨立驗證,權限範圍與真實業務效果要逐場景驗收。這句限定很重要,正是我在看任何 Agent 報告時最先找的一句。
至於目錄規模,Topkee 的資料寫明去重後有一定數量的條目,但同時註明那反映模板條目,數量不代表獨立成品,也不代表全部完成業務驗收。把它當成能力清單,而不是成績單。
企業落地前要核對的三件事
如果你正在看 ai 代理方案,或者要決定由哪個部門先試,以下三項檢查比看 benchmark 排名實用。
第一項,任務邊界。寫清楚這個 Agent 開始與結束的條件、輸入從哪裡來、輸出交去哪裡。GDPx 的任務之所以難,很大程度因為它刻意不給邊界;企業沒有理由複製這個難度。
第二項,失敗的可見度。要求每一步有記錄,失敗時能看到斷在哪裡,而不是只收到一個「完成」。沒有這層,你無法分辨 Agent 是做完還是放棄。
第三項,驗收指標。看完成率、用時、返工次數與人工介入比例,而不是看一個總分。這四項是 Topkee 落地方法裡明列的驗收看點,也是我在任何項目裡最先要求的四條基線。
要做到這三項,前提是系統真的接得通。erp 系統 整合要讓 Agent 在權限範圍內直接查詢與操作,不是把資料匯出成 Excel 再上傳。這一步做得不紮實,後面的驗收指標全部無意義。
下一步點做
我的建議是把範圍縮到一個可驗收的動作,例如每週的渠道表現摘要,或者一批名單的初步篩選,跑兩至三週,同時記錄上面四項基線。跑完再決定擴不擴。
要看長任務怎樣被拆成可追蹤的步驟,可以參考 Topkee 的 TTO Funnel Tuning Agent,它把漏斗診斷與行動處方拆成有狀態的步驟;若你的場景涉及電話跟進,可以看 Voice Agent。代理與自建團隊的分工,則可參考 Topkee 與代理商的比較。
常見問題
12% 是否等於十個任務只做到一個?
不是。這是達標率的定義:單趟計分,各領域權重相同。任務的難度分佈並不均勻,財務類在二值評分下全數為零,拉低整體的幅度比其任務數目更大。
為什麼最高分的那個模型,排名也會被質疑?
因為不同模型跑在各自提供方的 Agent 軟件裡,工具鏈有強有弱;同時安全分類器會壓低部分模型的總分,剔除三個領域後排名會改變。
財務任務全部得 0%,是否代表 AI 完全不會做財務?
不是。它代表在二值評分下,一個錯格就令整份產出不合格,而沒有模型做到零錯誤。改為計部分分之後,可以看到它們完成了幾多項要求,但仍然沒有一個任務被完整完成。
企業應該完全不用 AI Agent 嗎?
不應該一刀切。應該先縮窄任務邊界,選擇資料齊備、結果可驗收的場景,並以完成率、用時、返工與人工介入作為驗收指標,而不是以某個通用分數作判斷。
這個基準測試之後會更新嗎?
會。報道提到 SemiAnalysis 計劃每隔數月更新一次。看法從此改變時,要一併更新,不要停留在舊分數。
Sources
- Manuel Uth, "No AI agent scores above 12 percent on SemiAnalysis' new real-world work benchmark", The Decoder, 2026-11-06. https://the-decoder.com/no-ai-agent-scores-above-12-percent-on-semianalysis-new-real-world-work-benchmark/
- "GDPx: Measuring Frontier Model Capabilities Across the Most Valuable Domains", SemiAnalysis, 2026-11-02. https://newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities


